Héberger son assistant IA : un modèle Hermes avec Ollama sur un VPS à Montréal
Un modèle Hermes 8B quantifié tient dans 6 Go de RAM : le guide FFxF pour l'installer avec Ollama sur un VPS à Montréal, sans GPU, données au Canada.
 Priya Nair
October 22, 2026
Updated October 22, 2026
9 min read
Vous gérez un site WordPress et vous aimeriez un assistant qui réécrit vos fiches produit, trie vos commentaires ou résume vos tickets de support, sans que vos textes quittent une machine à vous ? Le 15 août 2026, l’équipe de FFxF, un hébergeur cloud canadien opéré à Montréal, a publié un guide complet pour héberger son assistant IA soi-même : un modèle Hermes, servi par Ollama, sur un VPS KVM. Leur méthode se résume en trois mots que j’aime beaucoup : « numbers before commands ». D’abord les chiffres, ensuite les commandes.
Le montage est sobre. Pas de carte graphique ni de grappe de serveurs : une machine virtuelle, de la RAM bien dimensionnée et un modèle quantifié. C’est précisément ce qui le rend accessible à quelqu’un qui administre déjà son propre site.
Un modèle 8B quantifié dans 6 Go de RAM, sans GPU
FFxF ouvre son guide sur la phrase qui donne le ton : « A quantized 8B model fits in 6 GB of RAM and answers at a few tokens per second with no GPU. » Un modèle de 8 milliards de paramètres, compressé au format Q4_K_M (le plus courant), pèse environ 4,7 Go de poids. Prévoyez 6 à 8 Go de RAM utilisable pour le faire tourner à l’aise. L’équipe parle de « sweet spot » sur un VPS. Je partage cet avis : c’est la taille par laquelle je commencerais.
Le guide donne toute l’échelle. Un modèle 3B tient dans 4 Go de RAM, pour environ 2 Go de poids. Un 14B demande 12 Go, pour environ 9 Go de poids. Et sur un 8B, ajoutez 1 à 2 Go si vous travaillez avec une fenêtre de 8 000 tokens de contexte. Ce détail-là, on le découvre d’ordinaire quand la machine commence à swapper. Ici, il est écrit en tête de page.
Tout le calcul se fait sur le processeur, et sa vitesse suit la bande passante mémoire. FFxF l’assume noir sur blanc dans sa FAQ : « Sustained CPU load is fine: computation, continuous builds, language model inference. » Pour un modèle qui tourne des heures durant, cette phrase compte autant que la fiche technique.
Le saviez-vous ?
La série Hermes 3 est publiée par Nous Research. La bibliothèque Ollama en recense quatre tailles : 3B, 8B, 70B et 405B. La version 8B porte l’étiquette « latest » : c’est elle que télécharge hermes3:8b, pour 4,7 Go. Source : bibliothèque Ollama, fiche hermes3, consultée le 22 octobre 2026.
Héberger son assistant IA sur un VPS KVM aux ressources dédiées
Pour un modèle de langage, la question décisive porte sur les ressources partagées. FFxF y répond sans détour : « vCPU, RAM, and storage are dedicated to your VM, we do not overprovision. » Les cœurs ne sont pas prêtés au voisin et la RAM n’est pas survendue. Le débit que vous mesurez un mardi matin reste donc celui que vous retrouverez le vendredi soir.
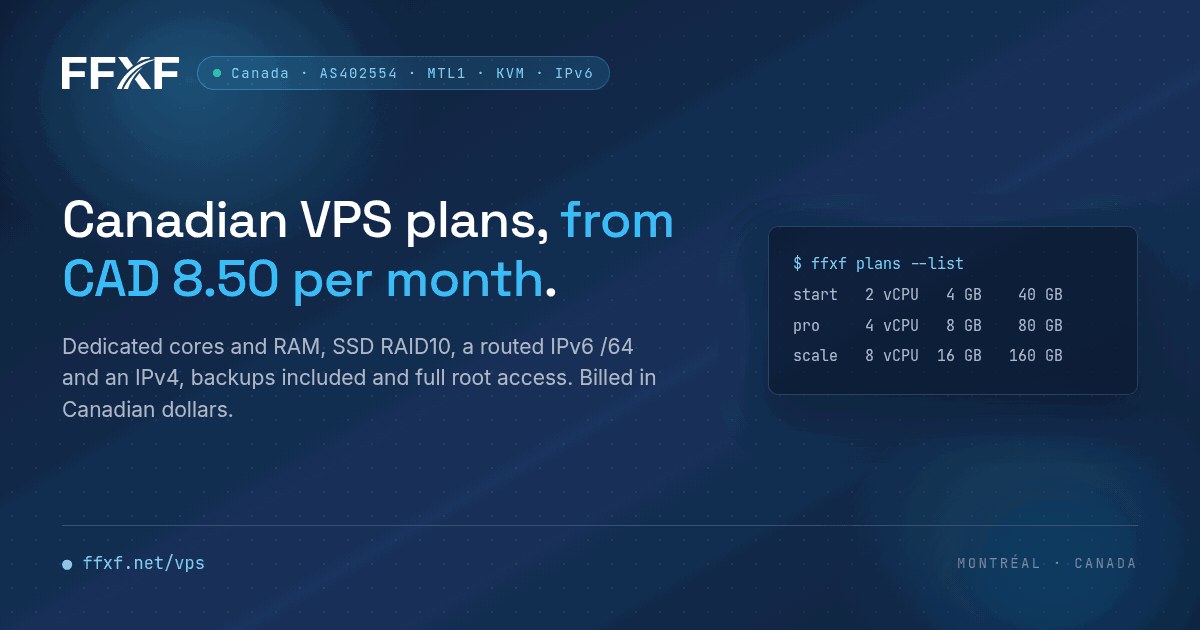
La machine démarre en moins de deux minutes, avec l’accès root, une IPv4 et un bloc IPv6 /64 routé déjà attribués. Les plans vont de Nano à Scale, à partir de 8,50 CAD par mois ou 0,018 CAD de l’heure. La facturation horaire a un vrai intérêt ici : vous pouvez monter une VM, charger Hermes, mesurer son débit sur vos propres textes, puis choisir la taille définitive en connaissance de cause. Et la première VM bénéficie d’un remboursement sous 7 jours, une fois par client.
De l’installation d’Ollama au service systemd, étape par étape
L’installation tient en une ligne : curl -fsSL https://ollama.com/install.sh | sh, suivie de systemctl status ollama --no-pager pour confirmer que le service tourne. Par défaut, le démon écoute sur 127.0.0.1:11434, uniquement en local. C’est le bon point de départ.
Vient ensuite le modèle. Le guide utilise ollama pull hermes3:8b et montre aussi comment récupérer un fichier GGUF sur Hugging Face, avec l’exemple d’un Hermes 4 en 14B quantifié Q4_K_M. Une fois le modèle téléchargé, la liste de contrôle de FFxF recommande un instantané (snapshot) de la VM. Excellent réflexe : vous repartez d’une machine prête sans retélécharger plusieurs gigaoctets.
Le réglage du démon passe par sudo systemctl edit ollama.service. Quatre variables suffisent. OLLAMA_HOST=127.0.0.1:11434 garde le service en local. OLLAMA_KEEP_ALIVE=30m fixe la durée pendant laquelle le modèle reste en mémoire après une requête. OLLAMA_NUM_PARALLEL=1 correspond au travail sur CPU, où un chiffre plus élevé « buys you nothing », selon l’équipe. Enfin, OLLAMA_MODELS=/var/lib/ollama/models indique où ranger les poids. Un daemon-reload, un redémarrage, et c’est en place.
Mon conseil sur ces quatre lignes : calez le keep-alive sur le rythme réel de vos appels. Si votre site interroge le modèle toutes les cinq minutes, 30 minutes de maintien en mémoire vous épargnent un rechargement à chaque fois.
Côté API, Ollama expose deux portes. La route native /api/chat, et une route compatible OpenAI, /v1/chat/completions. La seconde est la plus précieuse pour un administrateur de site : un outil qui parle déjà le format OpenAI se branche sur votre serveur en changeant simplement l’adresse. Pour mesurer le débit, FFxF donne la formule exacte : divisez eval_count (tokens produits) par eval_duration (en nanosecondes).
Un assistant Hermes sur un VPS FFxF : les repères chiffrés
6 Go
de RAM pour un modèle 8B quantifié, sans GPU
< 2 min
pour démarrer une VM avec root, IPv4 et IPv6 /64 routé
1 To
de trafic inclus par mois, puis 2 CAD par To, sans coupure ni ralentissement
8,50 CAD
par mois, ou 0,018 CAD de l’heure, pour le premier plan
−2 CAD
par mois avec l’option IPv6 seule, choisie à la commande
7 jours
de remboursement sur la première VM
Source : pages FFxF (guide Hermes du 15/08/2026, tarifs, VPS), lues le 22/10/2026.
Exposer l’API derrière un proxy authentifié
C’est la partie du guide que je préfère, parce qu’elle traite la sécurité comme une étape de l’installation à part entière. Ollama reste collé à 127.0.0.1. Devant lui, un Nginx en reverse proxy, avec un certificat TLS obtenu par Certbot et une authentification HTTP basique via un fichier htpasswd.
Deux réglages Nginx font la différence au quotidien. proxy_buffering off laisse passer la réponse au fil de l’eau, mot après mot. proxy_read_timeout 600s laisse aux longues générations le temps d’aboutir. Côté pare-feu, UFW n’ouvre que le port 443, et le guide fait vérifier depuis l’extérieur, avec nmap, que le port 11434 reste fermé. FFxF propose en plus un pare-feu cloud qui filtre le trafic avant même qu’il touche la VM. Les deux couches s’additionnent.
Des données hébergées au Canada, à l’heure ou au mois
FFxF opère son cloud à Montréal, sur son propre réseau AS402554, et facture tout en dollars canadiens. Pour un assistant qui lit vos brouillons, vos commandes ou les messages de vos clients, savoir où tournent les machines a de la valeur. L’hébergeur consacre d’ailleurs un guide entier à l’hébergement des données au Canada, avec la Loi 25 du Québec, la LPRPDE et le CLOUD Act.
Chaque VM inclut 1 To de trafic Internet par mois. Au-delà, la FAQ est formelle : « Beyond 1 TB nothing is cut off or slowed down: extra traffic is billed at 2 CAD per TB, pro rata ». Un modèle de langage renvoie du texte, donc très peu de données : ce plafond laisse une marge confortable. Et si vos outils parlent IPv6, l’option sans IPv4 publique retire 2 CAD par mois.
Dernier atout pour un montage à deux machines : les réseaux privés. Votre VM WordPress et votre VM Ollama se parlent hors d’Internet, et l’assistant n’a même plus besoin d’être visible publiquement.
Ce que le lecteur d’un site WordPress peut en tirer
Le guide est précis sur les usages qui tirent le meilleur d’un modèle local : des données qui doivent rester chez vous, un volume régulier et prévisible, et des tâches nettes comme la classification, l’extraction, la réécriture ou les résumés courts. Pour un site, ça se traduit très concrètement : ranger les commentaires par sujet, extraire les caractéristiques d’une fiche fournisseur, reformuler une description WooCommerce ou résumer chaque nouvel article pour la newsletter.
Sur 4 vCPU, FFxF estime qu’un 8B produit quelques tokens par seconde, soit 30 secondes à une minute par réponse. Ce rythme convient parfaitement aux traitements de fond. Une tâche planifiée qui passe la nuit sur vos 300 fiches produit n’a besoin d’aucune réactivité : elle a besoin d’une machine qui tient la charge, et l’hébergeur l’autorise explicitement.
FFxF propose aussi des images prêtes à déployer, dont WordPress, Docker et Hermes Agent. Le site et son assistant peuvent donc vivre chez le même hébergeur, dans la même ville, sur le même réseau privé.
Si je devais résumer la marche à suivre en une seule ligne : louez une VM à l’heure, chargez hermes3:8b, mesurez eval_count divisé par eval_duration sur vos propres textes, prenez un instantané, puis passez au mois.
Questions fréquentes
Faut-il un GPU pour faire tourner Hermes avec Ollama sur un VPS ?
Non. Selon le guide FFxF, un modèle 8B quantifié tient dans 6 Go de RAM et répond à quelques tokens par seconde sur le processeur, sans GPU. La vitesse dépend de la bande passante mémoire de la machine.
Combien de RAM prévoir pour un modèle Hermes ?
Au format Q4_K_M, FFxF indique 4 Go pour un 3B, 6 à 8 Go pour un 8B et 12 Go pour un 14B. Sur un 8B, ajoutez 1 à 2 Go pour une fenêtre de 8 000 tokens de contexte.
L’inférence en continu est-elle autorisée sur les VM FFxF ?
Oui. FFxF l’écrit dans sa FAQ : une charge CPU soutenue est acceptée, y compris pour l’inférence de modèles de langage. Les vCPU, la RAM et le stockage sont dédiés à chaque VM.
Comment rendre l’API Ollama accessible depuis un site de façon sécurisée ?
Le guide garde Ollama sur 127.0.0.1 et place devant lui un Nginx avec TLS (Certbot) et authentification basique, le buffering désactivé et un délai de lecture de 600 secondes. Seul le port 443 est ouvert. Avec un réseau privé FFxF, votre site peut aussi joindre le modèle sans passer par Internet.
Sources
FFxF, « Self-hosting a Hermes model on a VPS with Ollama », publié le 15 août 2026, consulté le 22 octobre 2026.
FFxF, pages Tarifs, VPS et Réseaux privés, lues le 22 octobre 2026.
Ollama, bibliothèque de modèles, fiche hermes3, consultée le 22 octobre 2026.
Priya Nair
Priya covers hosting, performance, security and backups. She reads changelogs and pricing pages so readers don't have to, and flags what changed since the last update.
Updated on October 22, 2026